深度学习调参技巧| kaggle 全球排名35th导师分享
布尔艺数导师 KKY 分享深度学习调参经验,从实验观察、训练效果与模型设置出发分析调参思路。
原文刊载于微信公众号「布尔艺数」,发布日期:2022-10-20。查看原文。以下为当时发布的内容。
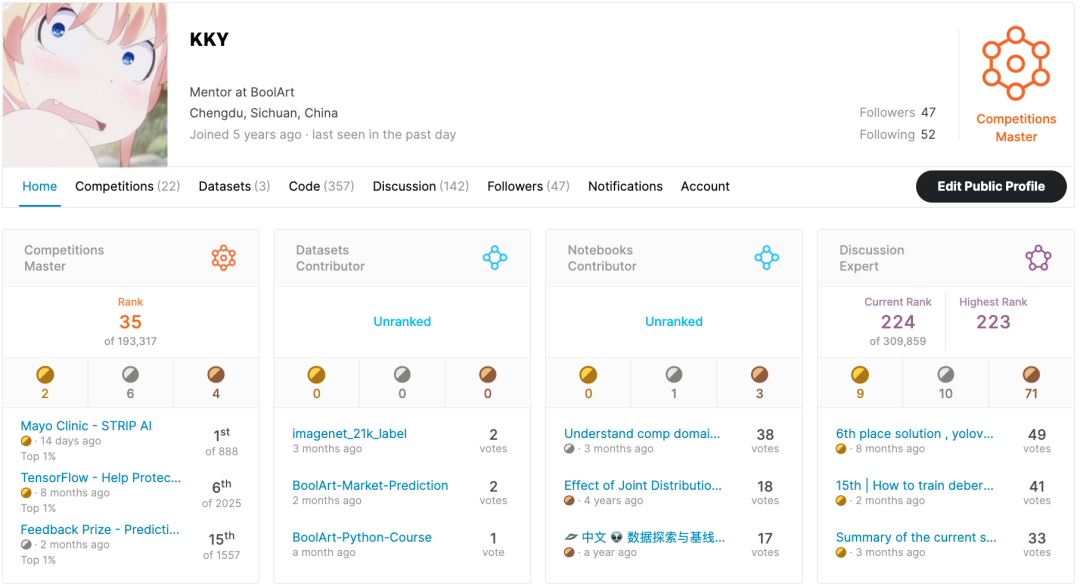
作者简介:布尔艺数合作导师,Kaggle Competition Master 全球排名35,前一线互联网公司算法专家,擅长多模态学习、CV、NLP、表示学习等领域。
KKY分享调参心得:
-
先overfit 再trade off,首先保证你的模型capacity能够过拟合,再尝试减小模型,各种正则化方法;
-
lr ,最重要的参数,一般nlp bert类模型在1e-5级别附近,warmup,衰减;cv类模型在1e-3级别附近,衰减;具体需要多尝试一下;
-
batch size 在表示学习,对比学习领域一般越大越好,显存不够上累计梯度,否则模型可能不收敛… 其他领域看情况;
-
dropout,现在大部分任务都需要使用预训练模型,要注意模型内部dropout ratio是一个很重要的参数,使用默认值不一定最优,有时候dropout reset到0有奇效;
-
初始化方法,linear / cnn一般选用kaiming uniform 或者normalize,embedding 一般选择截断 normalize,论文很多,可以去看看;
-
序列输入上LN,非序列上BN;
-
基于banckbone 构建层次化的neck 一般都比直接使用最后一层输出要好,reduce function 一般attention 优于简单pooling,多任务需要构建不同的qkv;
-
数据增强要结合任务本身来设计;
-
随机数种子设定好,否则很多对比实验结论不一定准确;
-
cross validation方式要结合任务设计,数据标签设计,其中时序数据要避免未来信息泄漏;
-
优化器,nlp,抽象层次较高或目标函数非常不平滑的问题adam优先,其他可以尝试下sgd(一般需要的迭代次数高于sgd);
-
不要过早的early stopping,有时候收敛平台在后段,你会错过,参考1. ,先过拟合train set。