开源时代的“黑马”:DeepSeek-R1模型详解
介绍 DeepSeek-R1 的训练思路,讨论强化学习、推理能力与开源模型的发展。
原文刊载于微信公众号「布尔艺数」,发布日期:2025-02-27。查看原文。以下为当时发布的内容。
近期,DeepSeek-R1模型在AI界引起了不小的轰动。这个模型不仅改变了业界和学界对大模型训练的认知,还以其超低的训练成本和卓越的性能,成为了全球AI领域的焦点。今天,我们就来深入探讨一下这款开源时代的“黑马”——DeepSeek-R1。
开源与高效的双重优势DeepSeek-R1在GitHub上发布了评估结果,涵盖了推理、编程、知识库等多个领域的Benchmark测试。从结果来看,R1系列模型的表现非常出色,许多指标甚至超过了OpenAI的GPT系列模型。更令人振奋的是,DeepSeek-R1是完全开源的,并且在自我验证、反思推理、编程和知识库等方面都表现出色。
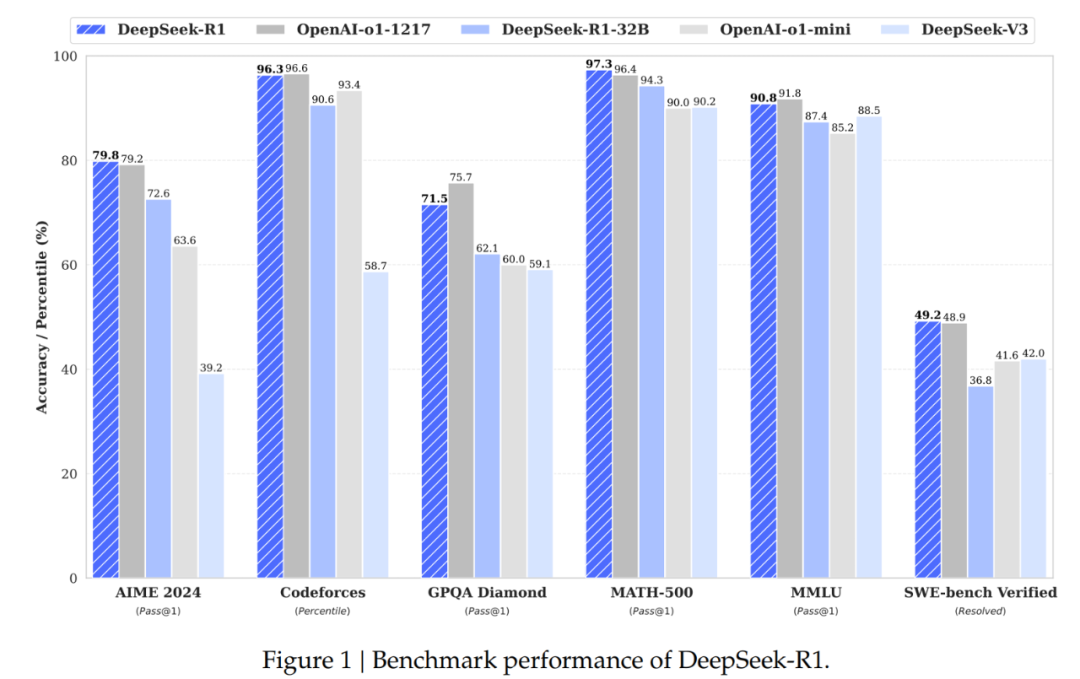
此外,DeepSeek-R1的训练成本仅为GPT-4的5%不到。这一突破不仅质疑了OpenAI等公司高成本的训练方式,也为AI模型的训练提供了新的思路。在开源与高效的双重优势下,DeepSeek-R1正迅速成为AI领域的“新宠”。
革命性的训练方法DeepSeek-R1的成功离不开其独特的训练方法。传统的模型训练通常包括预训练(Pre-training)、监督微调(Supervised Fine-tuning)和强化学习(Reinforcement Learning)。然而,DeepSeek-R1却完全摒弃了监督微调,仅通过强化学习来提升模型的推理能力。
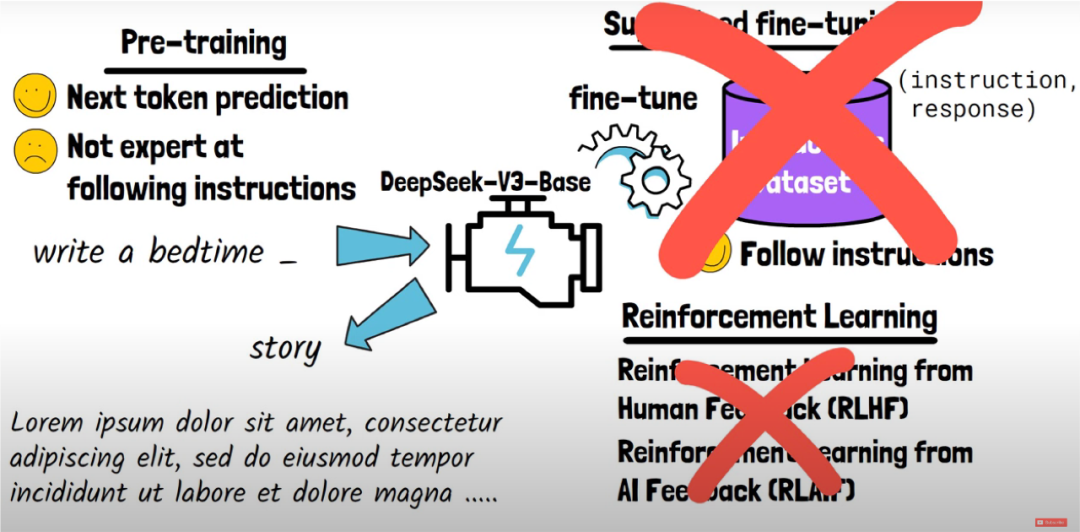
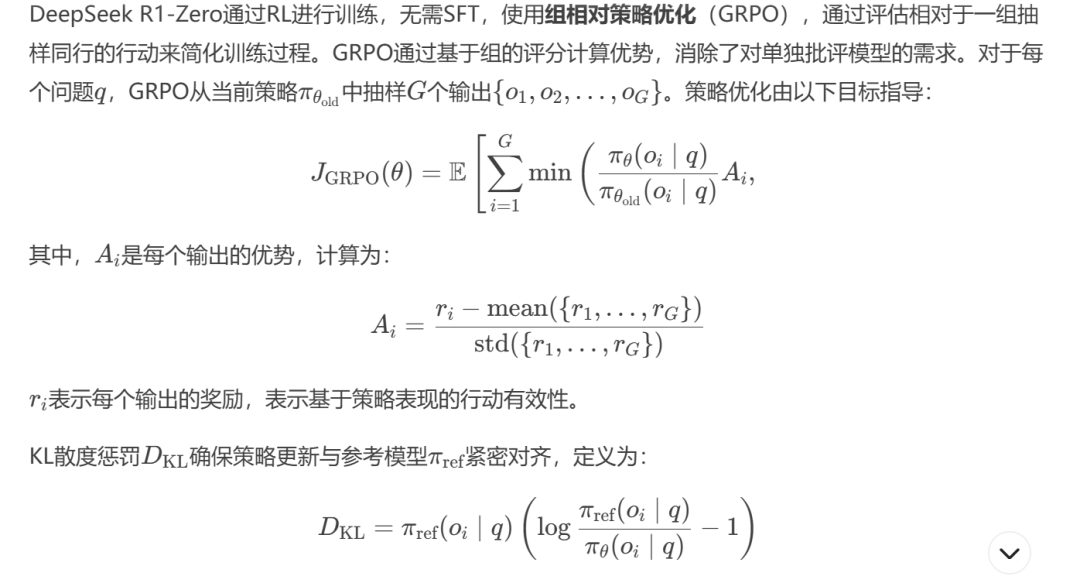
1. 强化学习(Reinforcement Learning)DeepSeek-R1采用了GRPO(一种经典的强化学习算法)来训练模型。具体来说,模型会生成多个答案,并通过计算每个答案的Reward来选择最优解。Reward主要包括两部分:
- 准确性奖励(Accuracy Reward):评估答案的正确性,例如数学问题的答案是否正确,编程代码是否通过测试等。
- 格式奖励(Format Reward):要求模型在输出答案时,必须包含“Think and Answer”的格式,即先输出推理过程,再输出最终答案。这种格式奖励的创新性在于,它不规定具体的推理方式,但要求模型展示其思考过程。
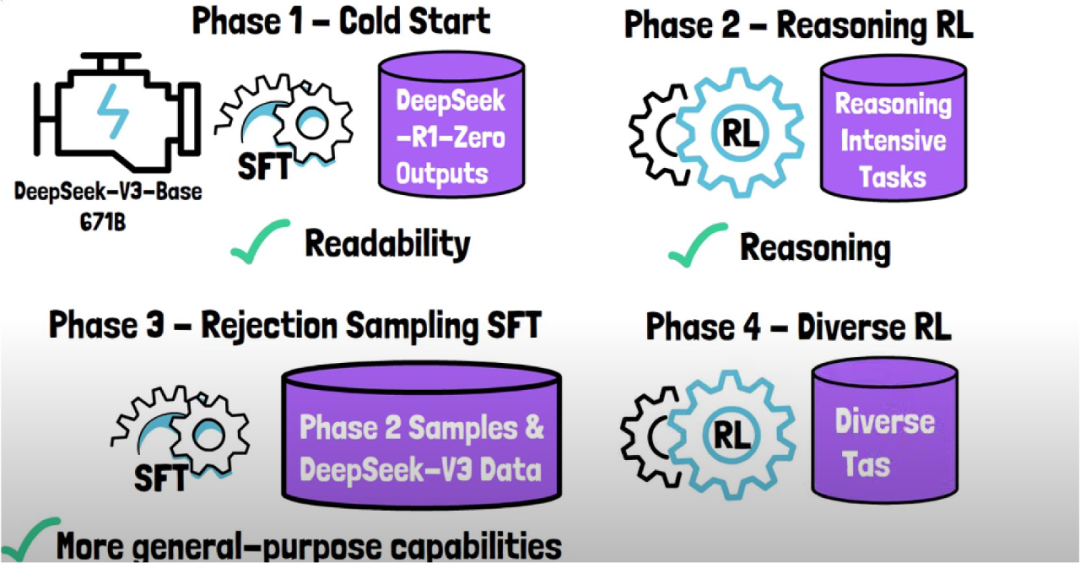
在正式使用前,DeepSeek-R1还进行了冷启动,即通过大量数据进行监督学习的微调。随后,模型进入强化学习阶段,不断优化其推理能力。有趣的是,DeepSeek-R1并不告诉模型“如何思考”,而是给予模型充分的自由去探索,最终展现出强大的推理能力。
此外,模型还采用了拒绝采样的方法,即在输出过程中丢弃不符合要求的内容,保留符合要求的部分作为监督数据,进一步微调模型。
模型架构:DeepSeek-V3DeepSeek-R1的模型架构基于DeepSeek-V3,这是一个经典的Transformer架构,但在两个关键部分进行了创新:MOE(Mixture of Experts)和MLA(Multi-head Latent Attention)。
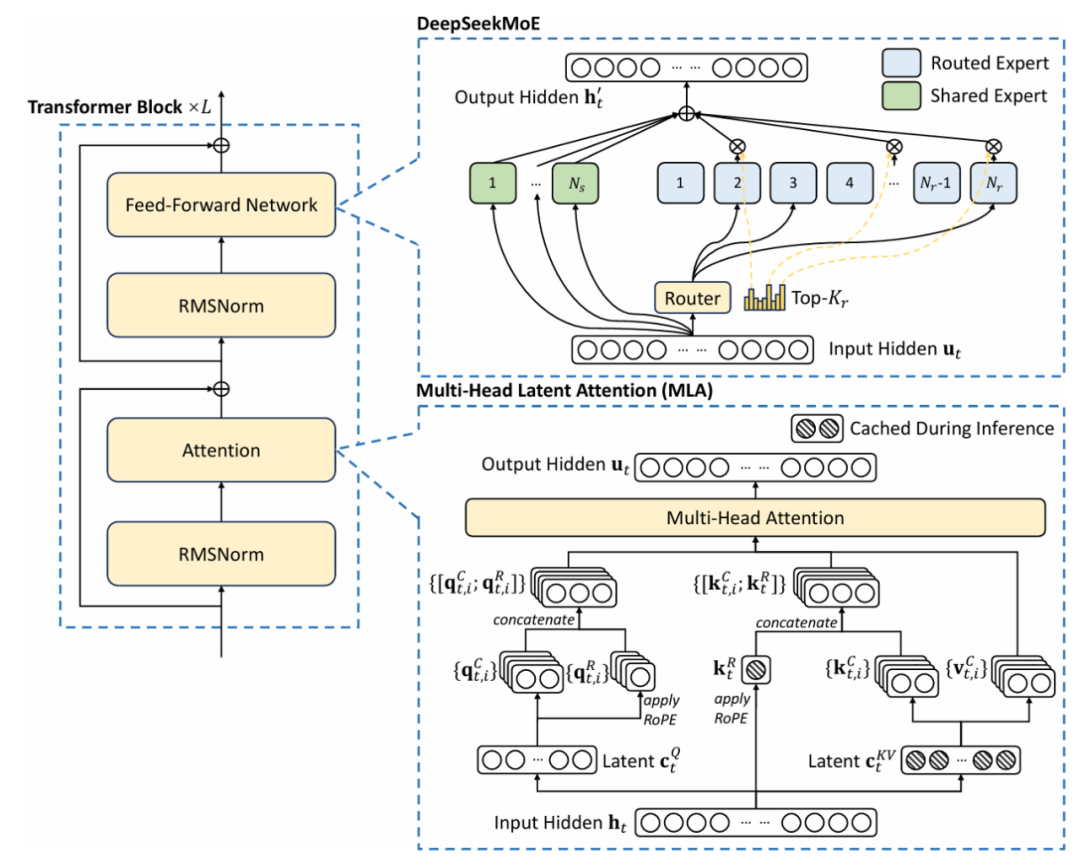
1. MOE架构MOE架构在前馈神经网络部分进行了优化。传统的专家模型通常不会进行如此细粒度的划分,而DeepSeek-V3将专家分为共享专家(Shared Expert)和路由专家(Routed Expert)。共享专家处理大部分输入,而路由专家则负责特定领域的细粒度计算。通过动态路由机制,模型能够根据输入内容激活相应的专家,从而降低内存负载,提升计算效率。2. MLA架构MLA架构在多头注意力机制(Multi-head Attention)上进行了改进。传统的多头注意力机制会将输入直接送入注意力层进行计算,而DeepSeek-V3则先将输入分别编码,再进行分解和计算。这种设计极大地降低了内存消耗,进一步提升了模型的效率。DeepSeek-R1的成功给我们带来了几点重要启示:
-
强化学习的潜力:通过强化学习提升模型的推理能力,而不依赖监督微调,这一方法极具革命性。未来,开源社区可以在此基础上进行更多探索。
-
低资源消耗:DeepSeek-R1的训练成本极低,仅为GPT-4的5%不到。这一突破为AI模型的训练提供了新的思路,尤其是在资源有限的情况下。
-
开源与轻量化:DeepSeek-R1已经发布了多个轻量化版本(如1.5B、7B、70B),并且完全开源。开发者可以直接使用这些模型进行测试和应用。
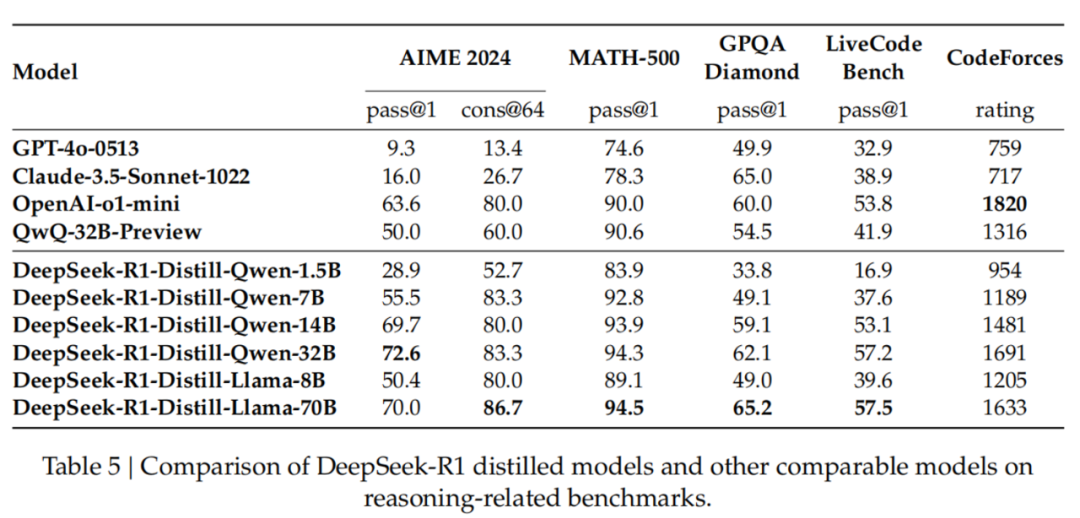

DeepSeek-R1的推出无疑是AI领域的一次重大突破。它不仅展示了强化学习在提升模型推理能力方面的巨大潜力,还通过低资源消耗和开源策略,为AI社区带来了新的可能性。如果你对AI模型感兴趣,一定要紧跟DeepSeek-R1的技术进展,未来它将有更多令人期待的应用场景。
如果你对DeepSeek-R1有更多问题或想法,欢迎留言讨论!